10月29日,清华大学生物医学工程学院周洪宇课题组联合国内外多家顶尖学术机构(AI for Medicine at Scale)在《自然·通讯》在线发表论文《大型推理模型在临床诊断中的准确性与安全性权衡》(The accuracy-safety trade-off of large reasoning models in clinical diagnostics)。研究基于真实世界电子病历,系统比较了大型推理模型与标准大语言模型在复杂临床诊断任务中的表现,发现推理能力在提高诊断准确性的同时,也带来了两方面代价:一是假阳性诊断增多,二是诊断结论的稳定性下降,即面对同一份病历重复诊断时,推理模型更容易给出不同的结论;而“推理模型先行、医生把关”的人机协同方式,能够在保留准确性优势的同时明显降低上述风险。
这项工作也是课题组今年6月在《自然·生物医学工程》(Nature Biomedical Engineering)提出“医学推理智能”(Medical Reasoning AI,MRAI)理念之后的一项实证研究,用真实数据回答了该理念中关于人机协同与验证成本的关键问题。周洪宇助理教授为论文主要通讯作者。
点击文末“阅读原文”获取更多论文信息
研究背景
大语言模型已在医学问答、病历总结等任务中展现出辅助临床决策的潜力。在此基础上发展起来的大型推理模型(Large Reasoning Models,LRMs),会在给出答案之前先进行逐步“思考”,生成显式的多步推理过程。一个直观的预期是:让模型多想一想,诊断应当更准确,也更可靠。
然而,临床诊断有其特殊性。真实病历往往篇幅较长,诊断线索分散在病史、体格检查、检验检查和病程记录之中;医生不仅要找出最可能的主要诊断,还需同时避免漏诊与误诊。推理能力究竟能带来多大收益、又会伴随哪些代价,此前缺乏基于真实病历的系统性比较。
为此,研究团队基于MIMIC-IV与eICU两个公开临床数据库,构建了长文本诊断推理基准AIMS-LDR,病历平均长度约2,657个token,明显长于现有常用医学评测数据集。研究选取6个主流模型(包括商用模型与开源模型),每个模型分别在思考与非思考两种模式下测试,覆盖12个临床专科。由于比较的是同一模型的两种工作模式,二者之间的差异可以较为直接地归因于推理过程本身。
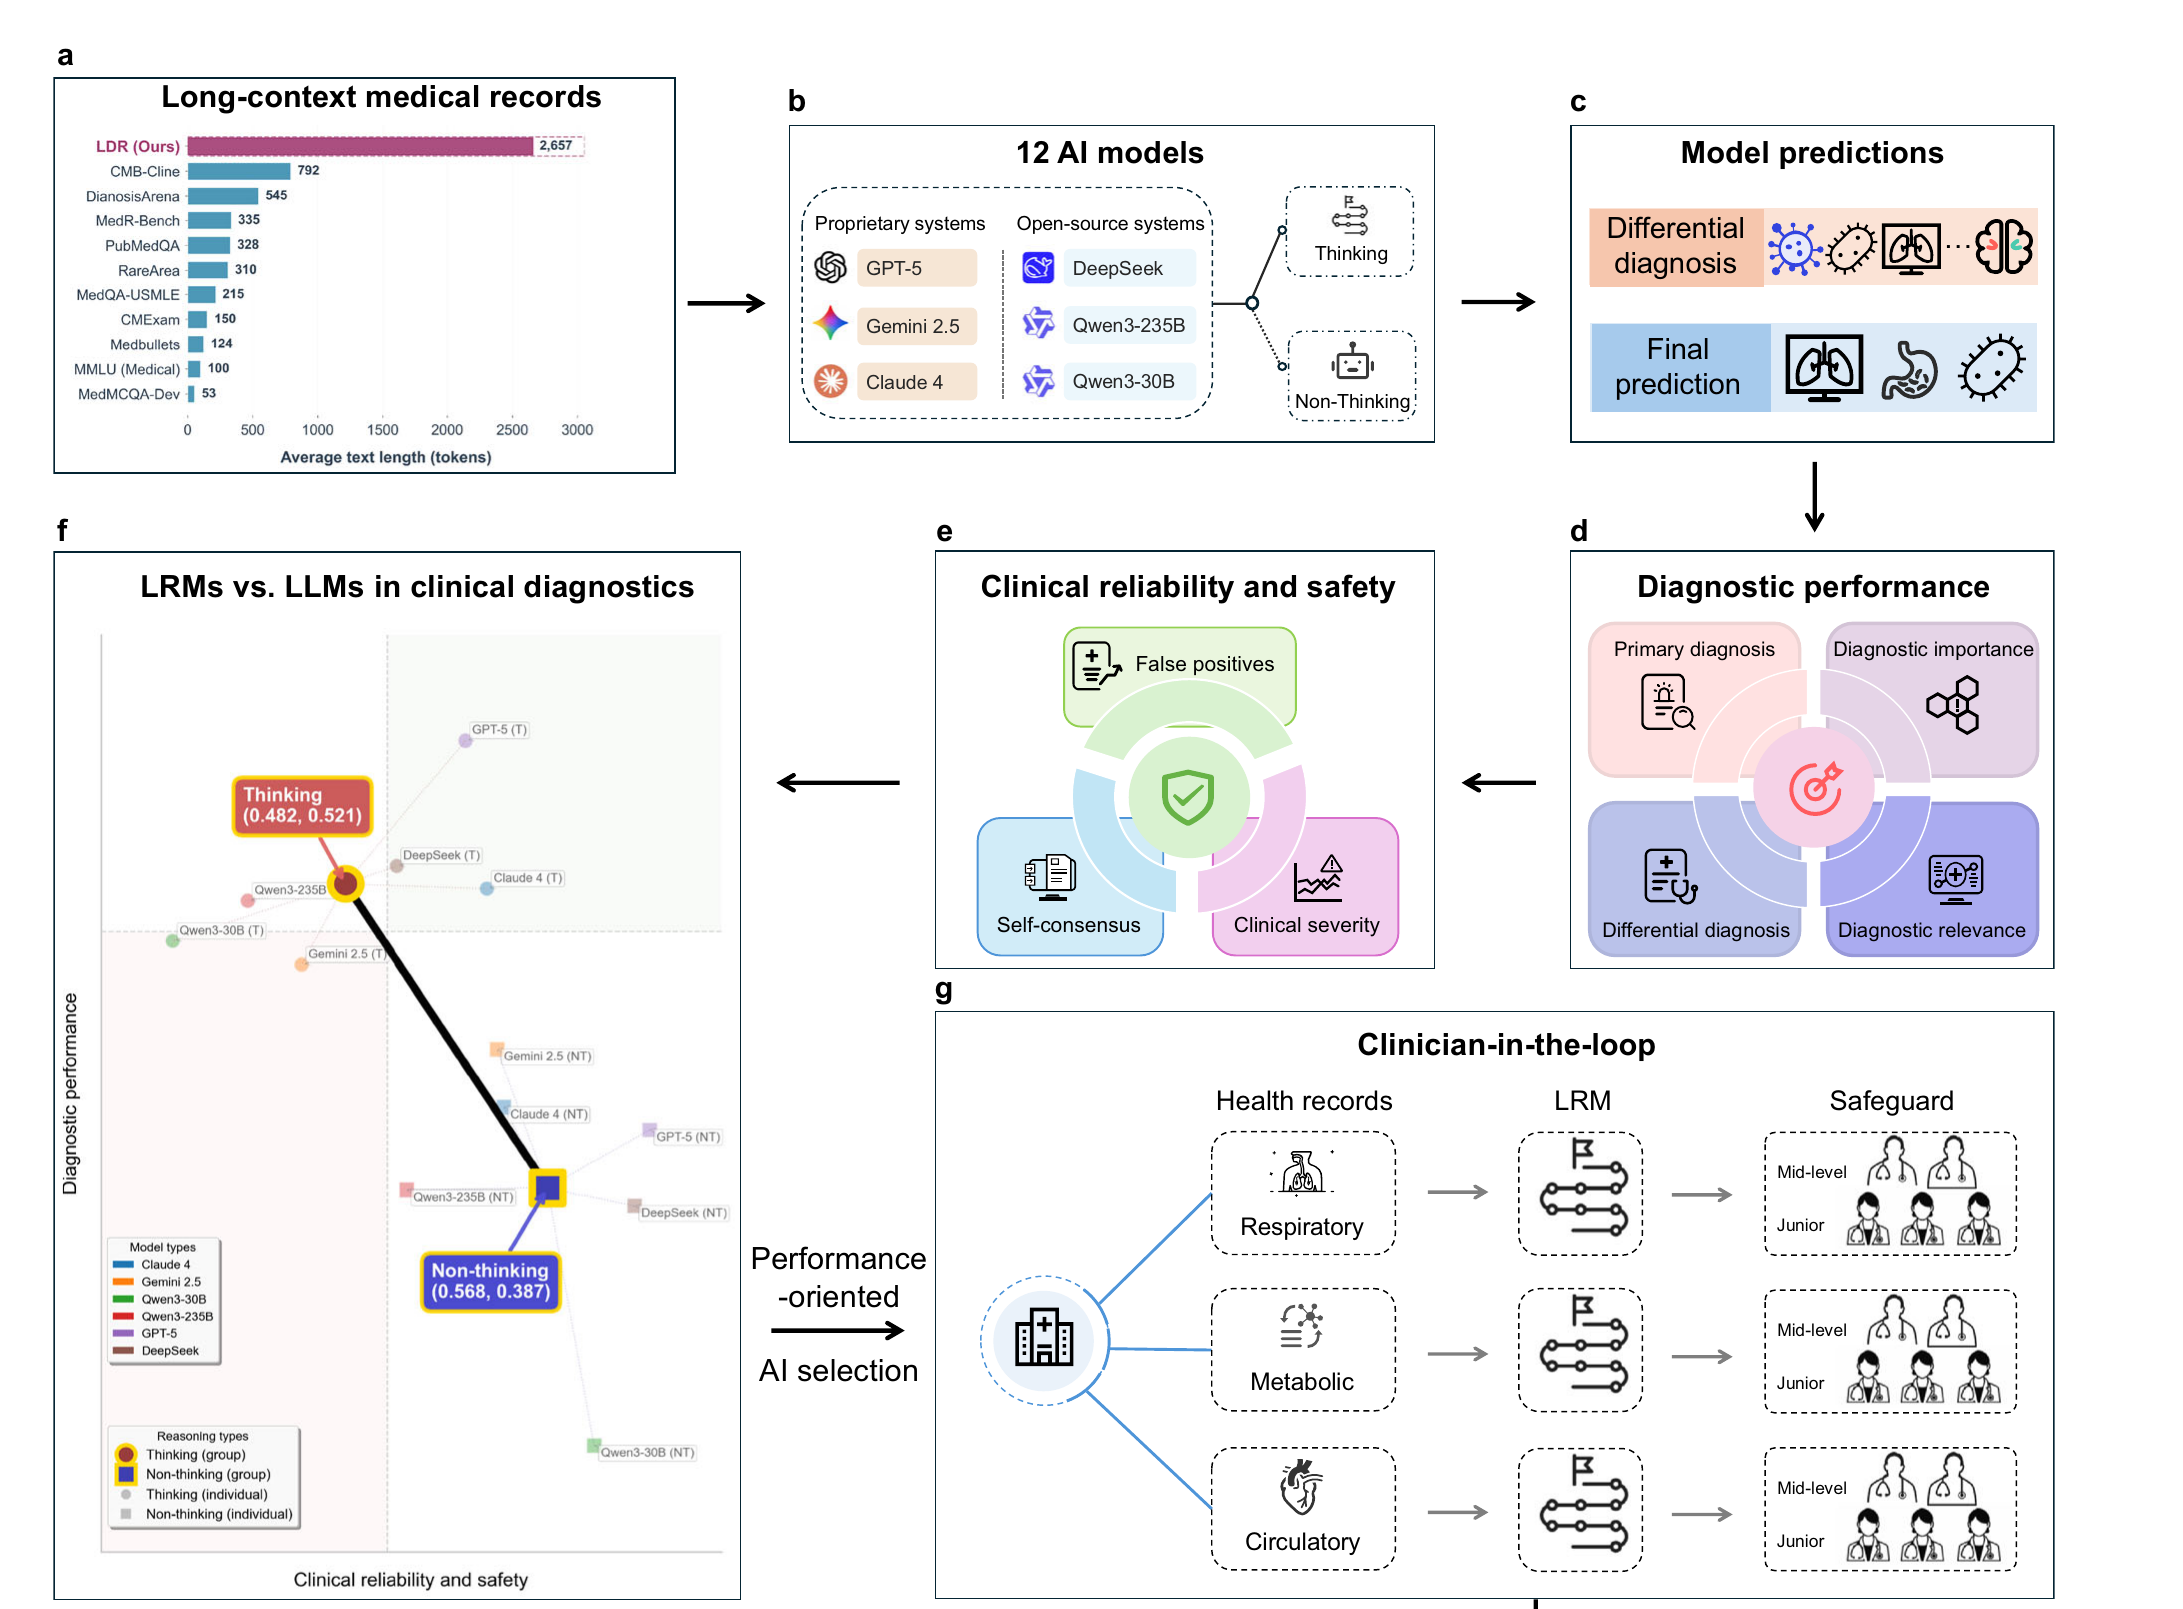
图1:研究整体框架(图片来源:论文原文)
主要发现
发现一:推理让诊断“更准”,出错时也“错得更近”
在识别主要诊断这一核心任务上,推理模式的优势稳定且明显。在LDR-MIMIC数据集上,推理模式的平均主要诊断准确率为52.8%,比非推理模式(38.7%)高出14.1个百分点;在独立的LDR-eICU数据集上同样观察到这一优势(35.1%对28.9%)。在生成鉴别诊断列表时,表现最好的推理模型前10位诊断的覆盖率达到84.3%,高于非推理模型的最佳结果(72.6%)。
研究还依据国际疾病分类(ICD)的层级结构,判断模型的预测与真实疾病“相差多远”。结果显示,推理模型给出临床无关预测的比例为32.8%,明显低于非推理模型的45.0%。也就是说,推理模型即使没有完全答对,其判断也更常落在正确的疾病类别或器官系统之内。
发现二:面对同一份病历,推理模型的结论更不稳定
稳定性是临床诊断工具最基本的要求之一:同一位患者、同一份病历,无论何时、由谁调用,系统都应给出一致的结论。如果同一份病历第一次被判断为肺炎、第二次又被判断为心力衰竭,即使其中一次是对的,医生也很难信任这样的工具。然而,现有医学AI评测大多只考察模型“答一次”的准确率,模型反复回答时是否前后一致,长期以来较少被系统检验。
为此,研究团队让每个模型在完全相同的输入下,对同一批病例独立重复诊断三次,并比较三次结论的一致程度。结果显示,推理模式的主要诊断一致性平均仅为52.3%,即约有近一半的病例,三次给出的主要诊断并不完全相同;而非推理模式为69.0%。在全部高优先级诊断层面,二者分别为43.0%与51.0%。总体而言,推理模式的可重复性比非推理模式显著降低,这一差距在独立的LDR-eICU数据集上同样得到复现。
一个自然的疑问是:这种不一致是否只是模型生成过程中的随机性所致?研究团队将采样温度设为0,尽可能消除随机采样带来的波动,结果差距依然明显:非推理模式的一致性为78.6%,推理模式仅为55.8%。这说明,结论不稳定并非简单的“抽样噪声”,而与推理过程本身密切相关。推理模型在得出结论前会展开较长的、带有探索性的推理链条,链条中任何一步的细微差异,都可能沿着后续推理被逐步放大,最终导向不同的结论。
这一发现的意义在于:推理能力在提高“答对的概率”的同时,降低了“每次都给出相同答案的概率”。单次评测中表现最好的模型,未必是临床上最可靠的模型。研究提示,评价医学推理模型时,应当将重复一致性与准确率一同纳入考量;在临床部署中,也需要为推理模型的结论设置医生复核等稳定性保障机制。
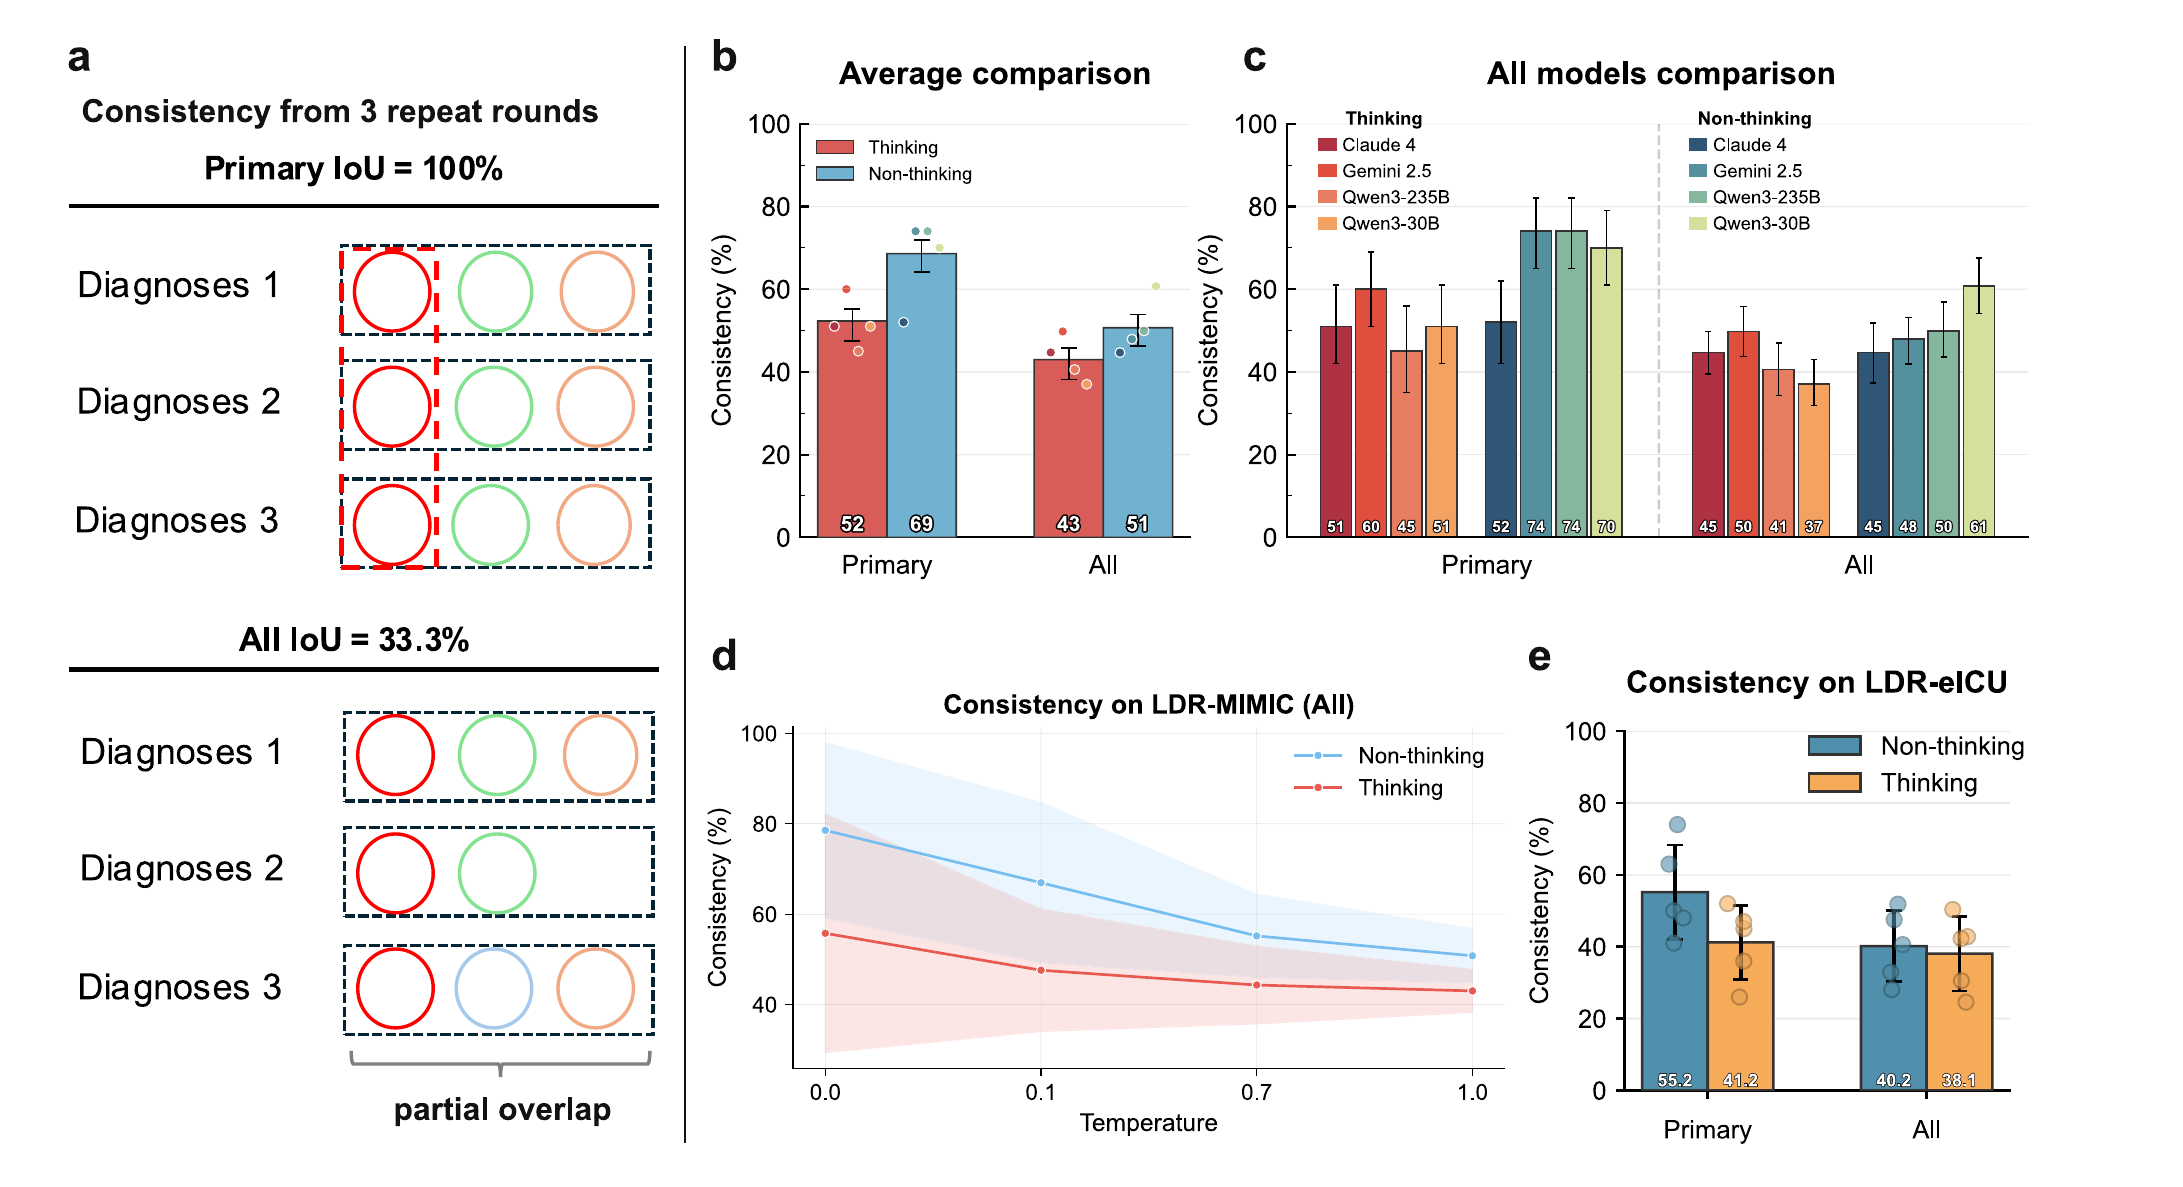
图2:a为推理模式与非推理模式在三次重复诊断中的一致性比较。b为平均结果,c为各模型结果,d为不同采样温度下的结果,e为LDR-eICU数据集上的复现(图片来源:论文原文)
发现三:推理也会让模型“想得太多”,假阳性明显增加
当要求模型完整、准确地给出全部高优先级诊断时,结果出现了反转:推理模式的精确匹配准确率反而略低于非推理模式(9.1%对10.9%)。原因在于假阳性,即模型给出了患者实际并不存在的诊断。推理模式平均每个病例产生1.47个假阳性诊断,非推理模式为1.09个,增加了34.8%。
为确认这一现象确实来自推理过程,研究团队利用GPT-5可调节推理强度的特点开展了对照实验:推理强度由低到高,诊断准确率逐步提高,每例假阳性数量也由0.92个增加至1.31个,呈现出清晰的“剂量-反应”关系。在更换提示词设计、去掉候选诊断列表改为完全开放式诊断等多种设置下,这一权衡关系依然成立,说明它反映的是模型层面的系统性行为,而非某一实验设置的偶然结果。
这些多出来的诊断并非无害的“标签”。研究对假阳性可能带来的下游负担进行了估算,涉及检验、用药、操作、诊疗科室与病情严重程度五个维度,推理模式对应的综合负担指数比非推理模式高出17.3%。错误分析进一步显示,在抽样分析的DeepSeek-R1假阳性病例中,超过一半源于推理过程与最终决策之间的不一致,或是将次要发现过度上升为主要诊断。这提示问题不仅在于模型“知道多少”,更在于模型“如何权衡并下结论”。
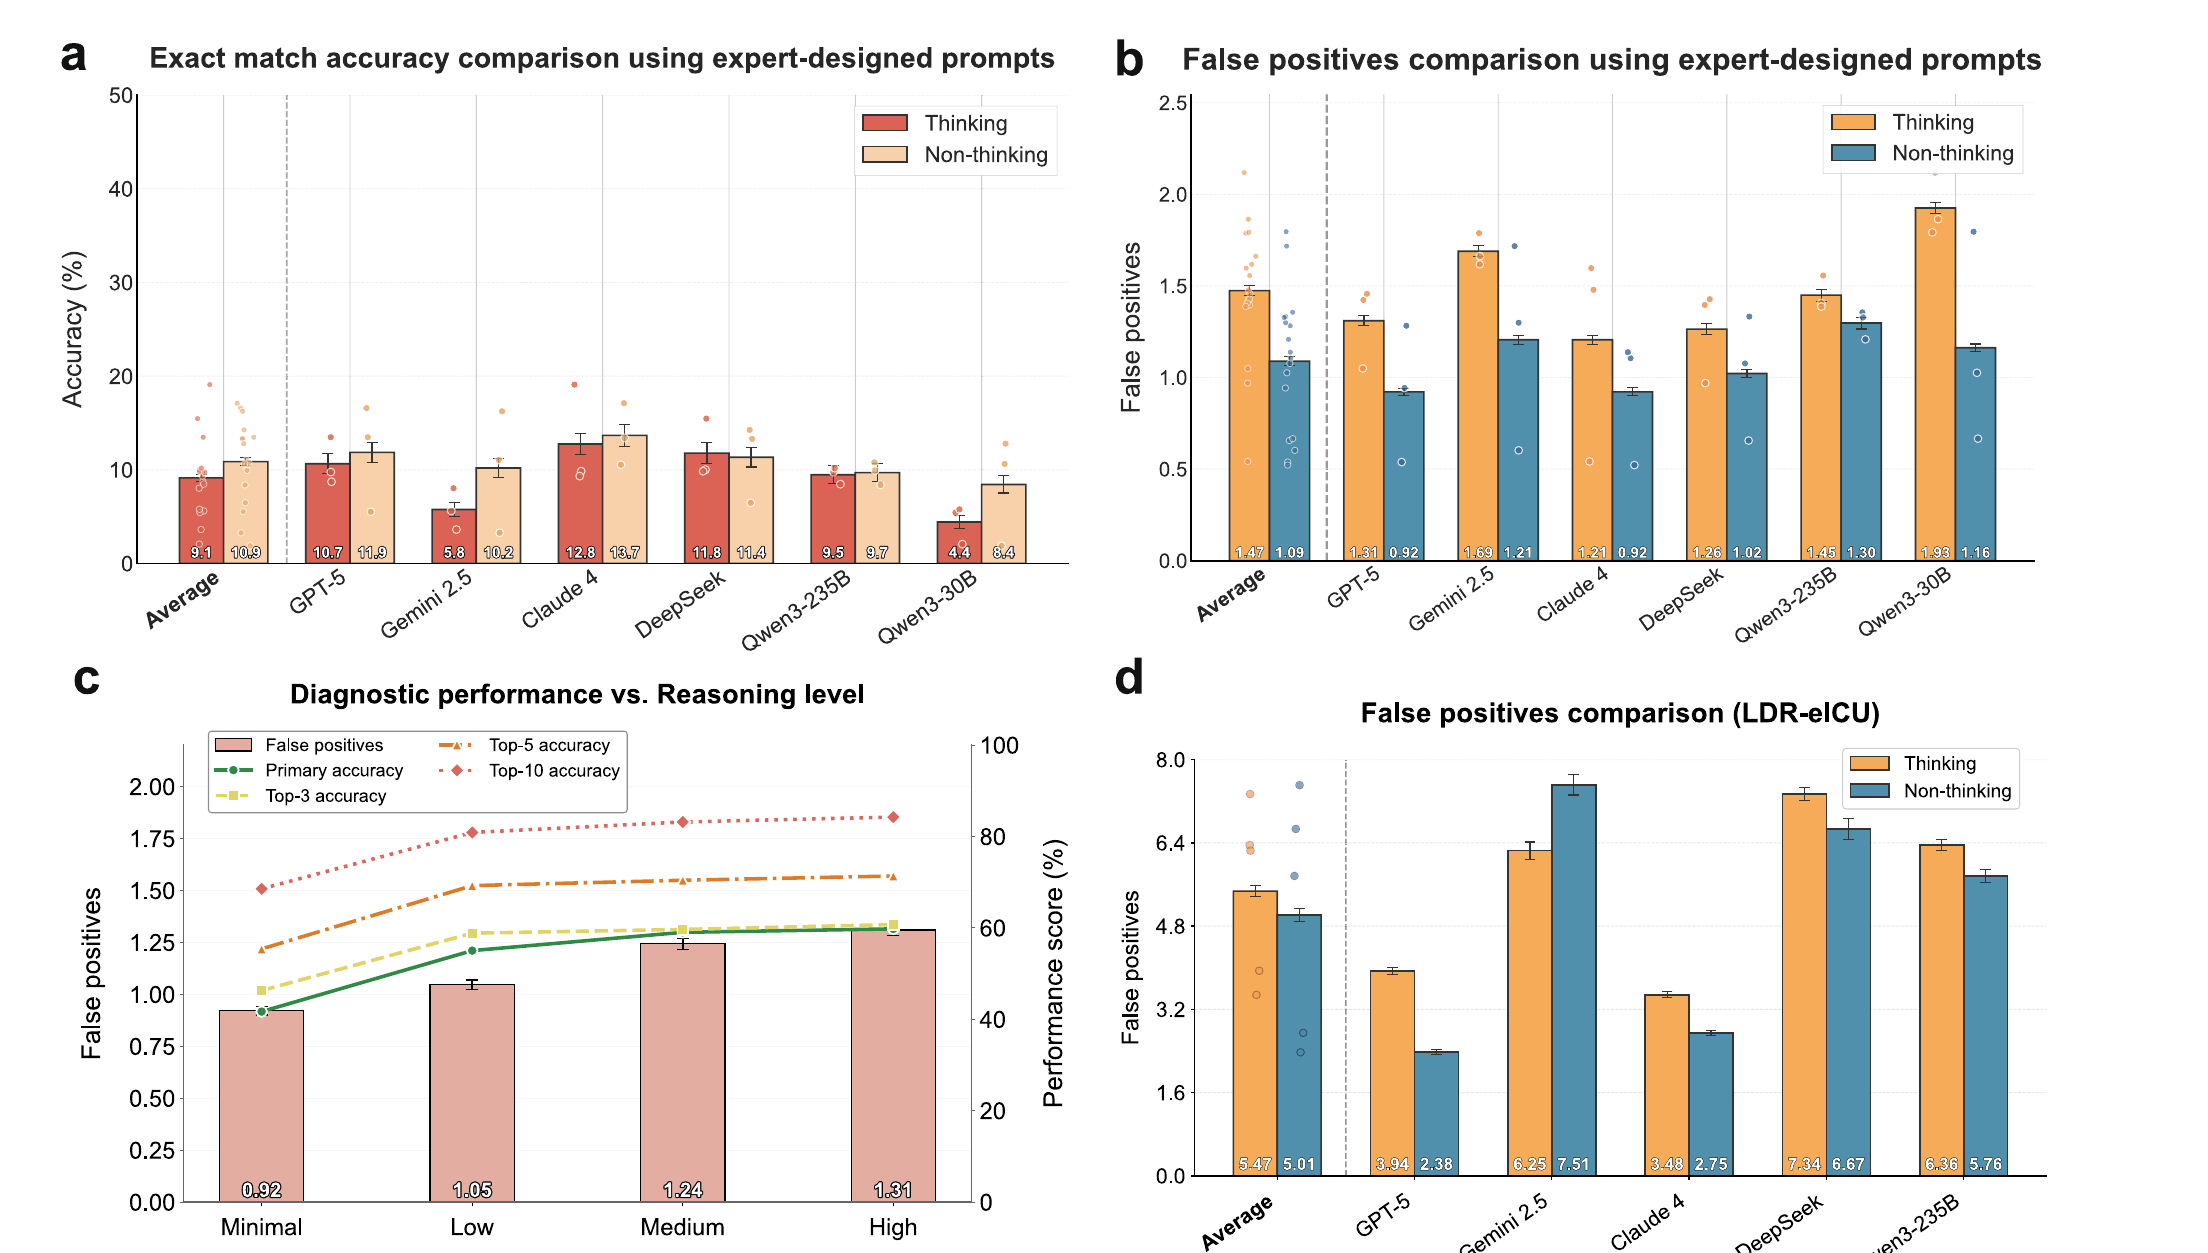
图3:推理模式与非推理模式的精确匹配准确率、假阳性数量,以及GPT-5推理强度与诊断表现、假阳性之间的关系(图片来源:论文原文)
发现四:“AI先行、医生把关”,准确性与安全性可以兼顾
既然推理模型“看得更全”但“不够稳”,一个自然的思路是让它与医生分工协作。研究团队招募15名不同年资的全科医生,围绕呼吸、循环、代谢三类疾病各50个病例开展验证:先由推理模型(GPT-5)给出诊断建议及推理过程,再由医生审阅后作出最终判断。
结果显示,在推理模型辅助下,医生的主要诊断准确率平均提升约20%,初级医生与中年资医生的提升幅度相近(20.1%与19.7%);与此同时,经医生审核后,推理模型的假阳性分别降低了43.6%(初级医生)与44.0%(中年资医生)。推理模型负责拓宽诊断思路,医生负责筛除错误并结合临床经验作出决断,二者结合的效果优于任何一方单独工作。
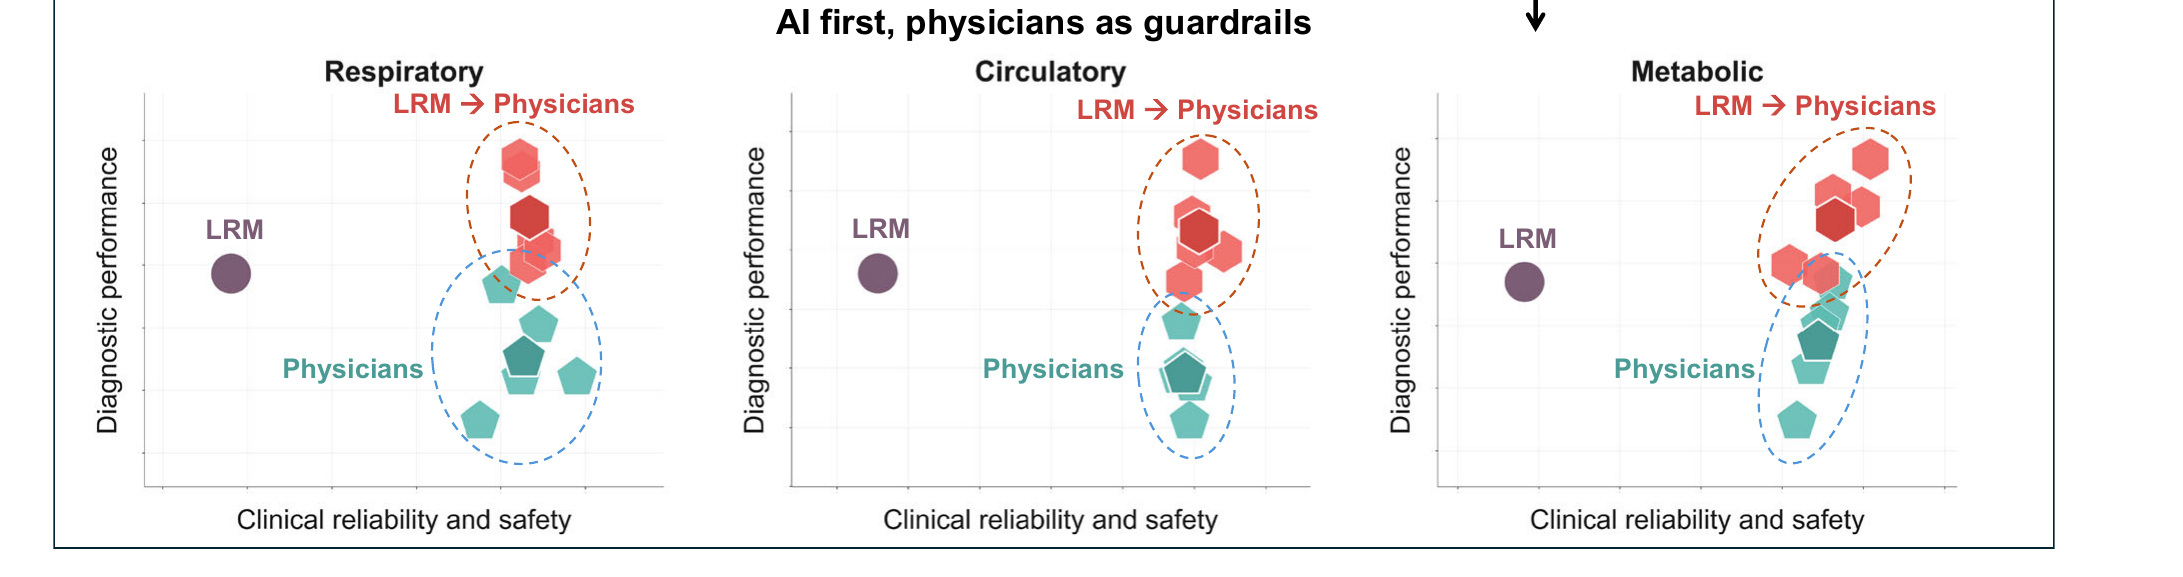
图4:“AI先行、医生把关”策略在三类疾病中同时提升诊断表现与临床可靠性(图片来源:论文原文)
从理念到实证
课题组在《自然·生物医学工程》论文中提出,医学推理智能的首要标准是持续的人机协同,并指出推理过程的透明化并非没有代价:它会把验证成本转移到临床使用的每一次交互之中。本项研究从数据层面为这两点提供了支持。
其一,推理带来的收益与风险是同时出现的,在多种实验条件下都难以通过调整模型设置来消除,人机协同因此不是锦上添花,而是推理模型进入临床的必要条件。其二,研究记录到,医生审阅包含完整推理过程的病例平均需要15至20分钟,而仅审阅简洁结论只需5至8分钟。这一结果直接印证了此前关于“验证负担”的判断:推理过程有助于医生核查,但也会加重医生的信息负荷。如何在保留可验证性的同时压缩推理内容、减轻审阅负担,将是推理模型临床集成需要解决的关键问题。
结语
这项研究表明,评价医学人工智能不能只看准确率,可靠性与安全性同样关键。大型推理模型能够提高诊断的准确性与临床相关性,但也伴随着假阳性增加和结果可重复性下降;在医生的结构化监督下,这些风险可以得到有效控制。需要指出的是,本研究为基于真实病历的回顾性评估,医生实验中也为医生提供了统一的候选诊断列表,相关结论在进入临床应用前仍需前瞻性研究的验证。
目前,课题组正围绕推理模型的置信度校准、推理内容的高效呈现以及人机协同诊断范式开展后续研究,欢迎相关领域同行交流合作,并在后续研究中引用与讨论本文工作。
论文原文链接:
https://doi.org/10.1038/s41467-026-78520-x
相关论文(Nature Biomedical Engineering):
https://doi.org/10.1038/s41551-026-01701-y
实验室简介
医学人工智能实验室AIMS Lab(AI for Medicine at Scale)于2025年由周洪宇博士创立,隶属于清华大学生物医学工程学院,专注于生物医学领域的人工智能基础算法研究与临床转化应用。实验室核心研究方向包括多模态医学基座模型、临床推理人工智能、个体化智能建模等前沿课题,致力于推动人工智能技术与临床医学实践的深度融合。周洪宇博士相关成果发表于《自然·医学》(Nature Medicine)、《自然·生物医学工程》(Nature Biomedical Engineering)、《自然·机器智能》(Nature Machine Intelligence)、《自然·通讯》(Nature Communications)、《新英格兰医学杂志人工智能》(NEJM AI)、《IEEE模式分析与机器智能汇刊》(IEEE TPAMI)等国际学术期刊。


 清华大学医学科学楼(清华大学西北门南行50米路西侧)
 62787861
 sygcxybgs@mail.tsinghua.edu.cn
 微信公众号

